1. 教程目标
Scrapy 本身不只是“发请求再解析 HTML”的工具,它更像一个可扩展的数据流引擎。当前项目的目标也不是采集单个页面, 而是用 Redis 驱动多个 Spider 协同工作:先抓大 V 微博,再根据微博派生评论、转发、点赞,再从互动用户继续派生用户详情和关注列表。
scrapy_redis.spiders.RedisSpider;起始 URL 来自 Redis;
解析结果以 Item 形式进入 Pipeline;Pipeline 一边写 MongoDB,一边继续向 Redis 写入下一阶段 URL。
建议先按本文顺序读一遍,再对照代码做二次阅读:
README.md:原始架构说明和启动顺序。weibo/settings.py:Scrapy、Redis、MongoDB、Middleware、Pipeline 的集中配置。weibo/items.py:所有数据类型、Redis 队列名和 API URL 模板。weibo/spiders/:每类数据的解析逻辑。weibo/pipelines.py:数据清洗、写库、派生 URL、布隆过滤。
2. Scrapy 架构速览
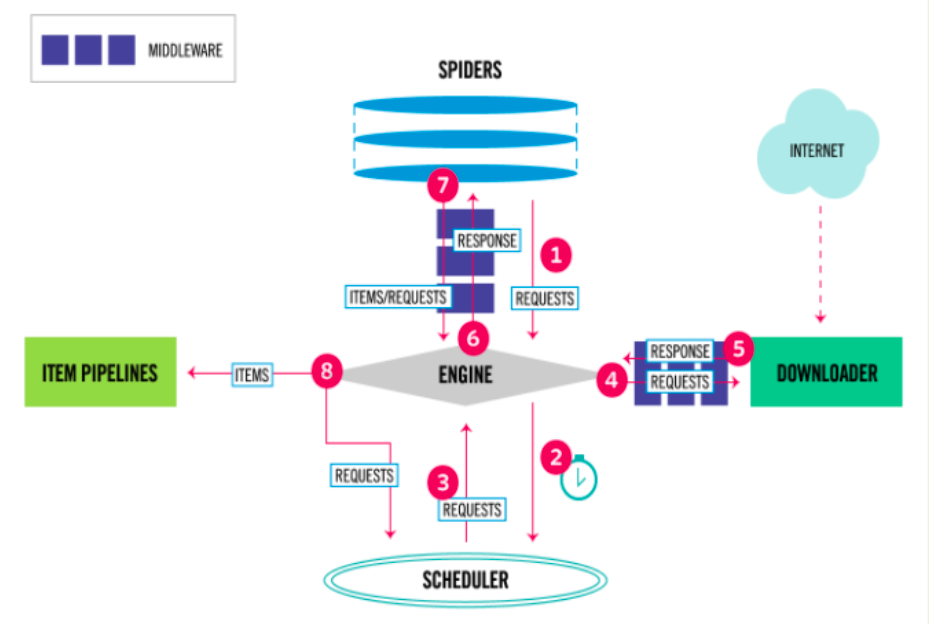
Scrapy 的核心链路可以理解成一个闭环:
Request 和 Item。Scrapy 内部数据流
普通 Scrapy 与本项目的区别
| 维度 | 普通 Scrapy | 本项目 |
|---|---|---|
| 起始 URL | 通常写在 Spider 的 start_urls 列表中。 |
写入 Redis,例如 m_weibo_redis:start_urls,Spider 从 Redis 拉取。 |
| 调度队列 | 内存或本地磁盘队列。 | scrapy-redis 使用 Redis 队列,可多进程、多机器共享。 |
| 去重 | 默认 RFPDupeFilter。 |
Scrapy 请求去重 + 项目自定义布隆过滤器,避免重复灌入起始 URL。 |
| 结果存储 | 常见是 JSON、CSV、数据库。 | MongoDB,按 Item 类型写入 weibos、comments、reposts、users 等集合。 |
3. 项目地图
weibocrawler/
├── scrapy.cfg                         # Scrapy 项目入口,默认 settings = weibo.settings
├── requirements.txt                   # Scrapy、scrapy_redis、pymongo、redis 等依赖
├── README.md                          # 原始架构、部署、启动顺序说明
├── weibo/
│   ├── settings.py                    # 全局配置:中间件、管道、Redis、MongoDB、限速
│   ├── items.py                       # Item 类型、集合名、Redis key、URL 模板
│   ├── pipelines.py                   # 时间字段、MongoDB 入库、派生 URL、布隆过滤
│   ├── middlewares.py                 # Cookie、跳转检测、代理、重试
│   ├── redis_init.py                  # 初始化 Redis 起始 URL
│   ├── run_spider.py                  # 以 mode 参数启动指定 Spider
│   └── spiders/
│       ├── m_weibo_redis.py           # 大 V 微博列表
│       ├── m_comment_redis.py         # 评论
│       ├── m_repost_redis.py          # 转发
│       ├── m_attitude_redis.py        # 点赞
│       ├── m_user_detail_redis.py     # 用户详情
│       ├── m_user_attention_tag_redis.py
│       └── m_user_attention_members_redis.py
配置层
settings.py 决定运行行为,包括 DOWNLOAD_DELAY、DOWNLOADER_MIDDLEWARES、ITEM_PIPELINES、REDIS_URL、MONGO_URI。
业务层
items.py 和 spiders/ 定义“采什么”和“怎么解析”。本项目采集的是微博接口返回的 JSON,不是传统 HTML 页面。
任务编排层
redis_init.py 负责把第一批 URL 放入 Redis;RedisStartUrlContinuePipeline 负责根据已采 Item 继续派生后续 URL。
存储层
MongoPipeline 使用 update_one(..., upsert=True) 写 MongoDB,并为常用查询字段建唯一索引或时间索引。
4. 从 settings.py 理解项目运行方式
weibo/settings.py 是 Scrapy 项目的控制台。理解这个文件,就能知道一次请求会经过哪些组件。
基础配置
BOT_NAME = 'weibo'
SPIDER_MODULES = ['weibo.spiders']
NEWSPIDER_MODULE = 'weibo.spiders'
ROBOTSTXT_OBEY = False
DOWNLOAD_DELAY = 0.3
RANDOMIZE_DOWNLOAD_DELAY = True
ROBOTSTXT_OBEY = False 表示不按 robots.txt 自动过滤 URL。DOWNLOAD_DELAY 和
RANDOMIZE_DOWNLOAD_DELAY 控制请求节奏,README 里也记录了不同场景下 M 站、PC 站的建议间隔。
下载器中间件
DOWNLOADER_MIDDLEWARES = {
    'scrapy.downloadermiddlewares.cookies.CookiesMiddleware': 101,
    'weibo.middlewares.CookieMiddleware': 100,
    'weibo.middlewares.RedirectMiddleware': 200,
}
Scrapy 会按优先级处理请求和响应。这里的重点是:
CookieMiddleware 从 MongoDB 账号池随机选可用 Cookie;
RedirectMiddleware 检查 302、403、414、418 或接口 ok=-100,判断 Cookie 或 IP 是否异常。
Item Pipeline
ITEM_PIPELINES = {
    'weibo.pipelines.RecentTimePipeline': 100,
    'weibo.pipelines.TimePipeline': 300,
    'weibo.pipelines.RedisStartUrlContinuePipeline': 398,
    'weibo.pipelines.RedisStartUrlFilterPipeline': 399,
    'weibo.pipelines.MongoPipeline': 400,
}
数字越小越先执行。一个 Item 从 Spider 产出后,会依次经过这些 Pipeline:先处理时间和通用字段,再派生下游 Redis URL,再记录过滤器,最后写 MongoDB。
scrapy-redis 配置
SCHEDULER = 'scrapy_redis.scheduler.Scheduler'
DUPEFILTER_CLASS = 'scrapy_redis.dupefilter.RFPDupeFilter'
SCHEDULER_PERSIST = True
SCHEDULER_FLUSH_ON_START = False
REDIS_START_URLS_AS_SET = True
这几行是分布式能力的核心。SCHEDULER_PERSIST = True 表示爬虫停止时 Redis 队列不清空;
SCHEDULER_FLUSH_ON_START = False 表示重启后继续消费旧队列;
REDIS_START_URLS_AS_SET = True 表示起始 URL 用 Set 存放,天然避免重复成员。
settings.py 中包含 Redis、MongoDB、DingTalk 等明文连接信息。教程层面可以理解其作用,但生产代码建议改为环境变量或密钥管理系统,避免仓库泄露造成风险。
5. Item:定义数据类型、Redis Key 和 URL 模板
在这个项目里,Item 不只是字段声明,还承担了三个职责:MongoDB 集合名、Redis 起始队列名、接口 URL 模板。
例如 WeiboItem:
class WeiboItem(Item):
    collection = 'weibos'
    start_url = 'm_weibo_redis:start_urls'
    start_url_filter = 'm_weibo_redis:filter'
    url = 'https://m.weibo.cn/api/container/getIndex?uid={uid}&type=uid&page={page}&containerid=107603{uid}'
    data = Field()
    first_row = Field()
常见 Item 对照表
| Item | MongoDB 集合 | Redis 起始队列 | 用途 |
|---|---|---|---|
WeiboItem |
weibos |
m_weibo_redis:start_urls |
采集大 V 微博列表,是主链路的起点。 |
CommentNewItem |
comments |
m_comment_redis:start_urls |
采集微博评论,并抽取评论用户。 |
RepostItem |
reposts |
m_repost_redis:start_urls |
采集微博转发,并抽取转发用户。 |
AttitudeItem |
attitudes |
m_attitude_redis:start_urls |
采集微博点赞用户。 |
UserDetailItem |
user_detail |
m_user_detail_redis:start_urls |
采集用户详情接口。 |
UserAttentionTagItem |
user_attention_tag |
m_user_attention_tag_redis:start_urls |
采集用户关注分组。 |
UserAttentionMemberItem |
users |
m_user_attention_member_redis:start_urls |
采集某个关注分组下的成员。 |
items.py 中把 collection、start_url、start_url_filter、url 定清楚。
这样 Spider 和 Pipeline 都可以复用这些常量,避免 Redis key 和 URL 模板散落在多个文件。
6. Spider:请求从 Redis 来,结果以 Item 返回
本项目的主要 Spider 都继承 RedisSpider。它与普通 scrapy.Spider 的最大区别是:
不依赖类属性 start_urls,而是监听 Redis key。
以微博列表 Spider 为例
class MWeiboRedisSpider(RedisSpider):
    name = 'm_weibo_redis'
    allowed_domains = ['m.weibo.cn']
    start_url = WeiboItem.start_url
    next_url = WeiboItem.url

    def parse(self, response):
        result = json.loads(response.text)
        if result.get('ok') == 1 and result.get('data').get('cards'):
            cards = result.get('data', {}).get('cards', [])
            uid = re.findall('uid=(\\d*)', response.url)[0]
            page = re.findall('page=(\\d*)', response.url)[0]
            for card in cards:
                weibo = card.get('mblog')
                if card.get('card_type') == 9 and weibo:
                    item = WeiboItem()
                    item['data'] = weibo
                    yield item
            yield Request(self.next_url.format(uid=uid, page=int(page) + 1), self.parse)
真实代码还做了两个重要处理:
- 通过
since_data = '2019-07-22'限定只继续翻页采集指定日期之后的微博。 - 每页成功后一次派生后面 3 页,注释说明这是为了应对可能的空数据页。
分页模式
| Spider | 分页参数 | 终止方式 |
|---|---|---|
m_weibo_redis.py |
page |
当微博创建时间早于 since_data 或接口无有效 cards 时停止。 |
m_comment_redis.py |
max_id |
接口返回新的 max_id 才继续请求下一页。 |
m_repost_redis.py |
page |
有 reposts 就继续加页;无数据记录错误并停止。 |
m_attitude_redis.py |
page |
有点赞数据就继续加页;接口无数据停止。 |
为什么要重写 make_requests_from_url
def make_requests_from_url(self, url):
    return scrapy.Request(url, dont_filter=True)
代码注释写到“新版本没有这个方法所以需要重写下”。在 scrapy-redis 老版本适配中,
这个方法用于把 Redis 里的 URL 字符串转换成 Scrapy Request。
dont_filter=True 表示 Redis 起始 URL 取出后不走默认请求去重,这对重跑、断点续爬、外部灌入任务有帮助。
7. scrapy-redis:把单机爬虫改造成分布式爬虫
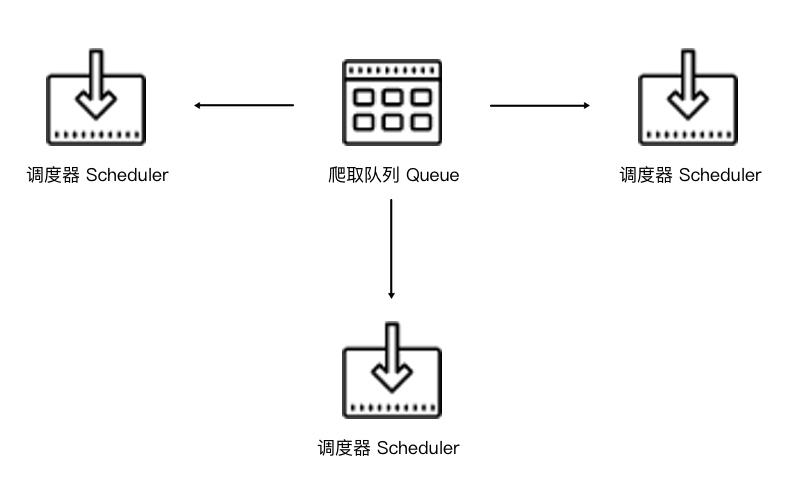
scrapy-redis 替换了 Scrapy 的 Scheduler 和 DupeFilter,让多个爬虫进程可以共享 Redis 中的请求队列。
本项目又额外使用 Redis Set 和布隆过滤器管理“业务起始 URL”。
初始化入口
weibo/redis_init.py 会把配置中的大 V UID 转成微博列表 URL,然后写入 WeiboItem.start_url:
def init_m_weibo_redis_spider():
    redis_utils.bak_weibo_filter()
    urls = []
    for init_weibo in INIT_USERS:
        urls.append(WeiboItem.url.format(uid=init_weibo, page=1))
    redis_init(WeiboItem.start_url, urls)
启动方式
# 初始化大 V 微博起始 URL
python weibo/redis_init.py weibo

# 启动微博列表 Spider
scrapy crawl m_weibo_redis

# 或使用封装脚本
python weibo/run_spider.py weibo
Redis Key 的两类用途
| 类型 | 示例 | 作用 |
|---|---|---|
| 起始 URL Set | m_comment_redis:start_urls |
等待某个 RedisSpider 消费的任务入口。 |
| 业务布隆过滤器 | m_user_detail_redis:filter |
避免 Pipeline 反复把同一个用户详情 URL 灌入 Redis。 |
| scrapy-redis 调度队列 | 由 scrapy_redis.scheduler.Scheduler 生成 |
Spider 运行过程中待下载 Request 的队列。 |
start_url 不是 Scrapy 原生的 start_urls。这里它是项目自定义命名,用来保存 Redis key;
真正起作用的是 RedisSpider 按 key 从 Redis 拉 URL。
8. Pipeline:本项目最重要的业务编排层
如果只看 Spider,会误以为每个 Spider 互相独立。实际联动关系主要写在 weibo/pipelines.py。
每一个 Item 经过 Pipeline 后,可能写库,也可能生成下一批 Redis URL。
TimePipeline:补充 crawled_at
class TimePipeline():
    def process_item(self, item, spider):
        data = item.get('data')
        if data:
            user = data.get('user')
            if user:
                user['crawled_at'] = datetime.now(tz=pytz.utc)
            data['crawled_at'] = datetime.now(tz=pytz.utc)
        return item
所有带 data 的 Item 都会补充抓取时间。如果数据里有嵌套 user,用户对象也会带上抓取时间。
RedisStartUrlContinuePipeline:派生下游任务
这是当前项目的“流程编排器”。典型规则包括:
WeiboItem且微博作者属于INIT_USERS:派生点赞、评论、转发 URL。CommentNewItem、RepostItem、AttitudeItem:从互动数据抽取用户 ID,派生用户详情和关注分组 URL。UserAttentionTagItem:从关注分组中派生关注成员 URL。UserSearchItem、UserAttentionMemberItem:派生用户详情 URL。
if isinstance(item, WeiboItem):
    weibo_id = item.get("data").get("id")
    self.conn.sadd(AttitudeItem.start_url, AttitudeItem.url.format(weibo_id=weibo_id, page=1))
    self.conn.sadd(CommentNewItem.start_url, CommentNewItem.url.format(id=weibo_id, max_id=0))
    self.conn.sadd(RepostItem.start_url, RepostItem.url.format(id=weibo_id, page=1))
RedisStartUrlFilterPipeline:记录已处理入口
该 Pipeline 用布隆过滤器记录已经产生过的业务入口。例如用户详情抓完后,把
UserDetailItem.url.format(user_id=user_id) 写入 UserDetailItem.start_url_filter。
后续 Pipeline 想再次添加相同用户详情 URL 时,会先查过滤器。
MongoPipeline:清洗并写库
MongoPipeline 做了三类事:
- 在
open_spider中连接 MongoDB,并为各集合创建索引。 - 按 Item 类型清洗数据,例如把嵌套
user拆到users集合。 - 用
update_one(..., upsert=True)做幂等写入,避免重复采集导致重复记录。
if isinstance(item, CommentNewItem) or isinstance(item, RepostItem) or isinstance(item, AttitudeItem):
    data = item.get('data')
    user = data.get('user')
    if user:
        self.db['users'].update_one({'id': user.get("id")}, {'$set': user}, upsert=True)
        del data["user"]
self.db[item.collection].update_one({'id': data.get('id')}, {'$set': data}, upsert=True)9. Middleware:Cookie、异常响应和代理
微博采集很依赖登录态和请求稳定性,所以本项目的下载器中间件很关键。
CookieMiddleware
CookieMiddleware 在每次请求前,根据 URL 判断是 PC 站还是 M 站,再从 MongoDB 的 weibo.account
集合中随机取一个状态为 success 的账号 Cookie。
def process_request(self, request, spider):
    is_pc = request.url.find("weibo.com") != -1
    if is_pc:
        self.pc_cookie(request)
    else:
        self.m_cookie(request)
RedirectMiddleware
该中间件在响应阶段判断账号或 IP 是否异常:
302、403:通常表示 Cookie 或账号状态异常。418、414:通常表示 IP 风控异常。- JSON 中
ok == -100:触发钉钉通知,并把账号状态更新为 error。 - JSON 解析失败:记录错误并返回原请求重试。
代理相关中间件
ProxypoolMiddleware 可以从代理池获取代理并写入 request.meta['proxy']。
ProxyDecreaseMiddleware 根据 HTTP 状态码或连接异常降低代理评分,或者在成功状态下提高代理评分。
当前全局配置中代理中间件是注释状态,说明项目可按部署环境启用。
10. 用一次完整微博采集流程串起来
结合 README 和代码,主流程可以这样理解:
本项目业务流程图
weibo.account 可用 Cookie;Redis 用于队列;MongoDB 用于结果表。
python weibo/redis_init.py weibo 读取 INIT_USERS,生成 WeiboItem.url,写入 m_weibo_redis:start_urls。
m_weibo_redis 从 Redis 拉 URL,解析微博列表,产出 WeiboItem,写入 weibos。
RedisStartUrlContinuePipeline 写入评论、转发、点赞起始 URL。
m_comment_redis、m_repost_redis、m_attitude_redis 抽取互动用户,并写入对应集合。
user_detail 和 user_attention_tag;再从关注分组派生 user_attention_member。
user_detail、user_attention_tag、users 等集合。
推荐启动顺序
# 1. 初始化大 V 微博入口
python weibo/redis_init.py weibo

# 2. 采集大 V 微博
python weibo/run_spider.py weibo

# 3. 采集互动数据
python weibo/run_spider.py comment
python weibo/run_spider.py repost
python weibo/run_spider.py attitude

# 4. 采集用户关注关系和详情
python weibo/run_spider.py user_attention_tag
python weibo/run_spider.py user_attention_member
python weibo/run_spider.py user_detail11. 如何按本项目模式新增一个 Spider
假设要新增一个“采集某类用户标签”的微博 API,建议按下面步骤做。
步骤 1:在 items.py 定义 Item
class UserSomeTagItem(Item):
    collection = 'user_some_tag'
    start_url = 'm_user_some_tag_redis:start_urls'
    start_url_filter = 'm_user_some_tag_redis:filter'
    url = 'https://m.weibo.cn/api/example?uid={user_id}&page={page}'
    data = Field()
    first_row = Field()
步骤 2:新增 RedisSpider
class MUserSomeTagRedisSpider(RedisSpider):
    name = 'm_user_some_tag_redis'
    allowed_domains = ['m.weibo.cn']
    start_url = UserSomeTagItem.start_url
    next_url = UserSomeTagItem.url

    def parse(self, response):
        result = json.loads(response.text)
        if result.get('ok') == 1:
            for row in result.get('data', {}).get('list', []):
                item = UserSomeTagItem()
                item['data'] = row
                yield item

    def make_requests_from_url(self, url):
        return scrapy.Request(url, dont_filter=True)
步骤 3:在 Pipeline 中写存储和派生逻辑
如果新 Item 只需入库,可以在 MongoPipeline._process_item 中增加一个 isinstance 分支。
如果新 Item 还会派生下游 URL,就在 RedisStartUrlContinuePipeline._process_item 中增加对应规则。
步骤 4:注册启动入口
如果用 scrapy crawl,只要 Spider 类在 weibo/spiders/ 下并有唯一 name 即可。
如果用 run_spider.py,还需要把 mode 映射到 Spider 类。
mode_to_spider = {
    'user_some_tag': MUserSomeTagRedisSpider,
}
步骤 5:准备 Redis 起始 URL
redis-cli SADD m_user_some_tag_redis:start_urls \
  'https://m.weibo.cn/api/example?uid=123456&page=1'
12. 调试与排障
先确认 Scrapy 是否能找到项目配置
scrapy settings --get BOT_NAME
scrapy list
如果找不到 Spider,优先检查 scrapy.cfg、SPIDER_MODULES 和当前工作目录。
检查 Redis 队列
redis-cli SCARD m_weibo_redis:start_urls
redis-cli SMEMBERS m_weibo_redis:start_urls
redis-cli SCARD m_comment_redis:start_urls
如果 Spider 启动后一直 idle,多半是对应 start_urls key 为空,或者 Redis 连接配置不对。
检查账号池
// Mongo shell 示例
db.account.countDocuments({ m_status: 'success' })
db.account.countDocuments({ pc_status: 'success' })
如果账号池为空,CookieMiddleware 会抛异常并通过钉钉通知。M 站和 PC 站使用不同字段:
m_status/m_cookie 与 pc_status/pc_cookie。
看日志
tail -fn 1000 logs/scrapy_$(date +%F).log
成功下载会出现 成功下载 {url};接口异常会出现 Result not ok、No Comments Data、
Json decode error 等信息。根据日志里的 URL 回到对应 Spider 的解析逻辑定位。
常见问题
| 现象 | 可能原因 | 处理方向 |
|---|---|---|
| Spider 启动后无请求 | Redis 起始 URL 为空;mode 对错;连接到错误 Redis DB。 | 检查 REDIS_URL、SCARD start_urls、run_spider.py mode。 |
| 大量 403、302、ok=-100 | Cookie 失效或账号被限制。 | 更新 weibo.account 中的 Cookie 和状态字段。 |
| 大量 418、414 | IP 被风控或请求过快。 | 增大 DOWNLOAD_DELAY,启用代理池,降低并发。 |
| MongoDB 重复键错误 | 唯一索引字段与写入过滤条件不一致。 | 检查 MongoPipeline.open_spider 建索引字段和 update_one 查询条件。 |
| 下游任务没有生成 | Item 类型未进入对应 Pipeline 分支;布隆过滤器判断已存在;字段缺失。 | 检查 RedisStartUrlContinuePipeline 和 RedisStartUrlFilterPipeline。 |
13. 学习与开发检查清单
理解现有爬虫
- 先看
items.py确认数据类型、队列和 URL。 - 再看 对应
spiders/*.py的parse。 - 最后看
pipelines.py判断数据写到哪里、派生什么任务。
新增爬虫前
- 确认接口返回是 HTML 还是 JSON。
- 确认分页参数和停止条件。
- 确认唯一键字段,避免 MongoDB 写入重复。
- 确认是否会派生下游 URL。
上线运行前
- 检查 Redis、MongoDB、账号池配置是否指向预期环境。
- 检查
DOWNLOAD_DELAY、代理和 Cookie 策略。 - 先用少量 URL 验证日志和 MongoDB 数据。
- 确认异常通知不会刷屏。
代码质量
- Spider 只负责解析当前响应。
- 存储、清洗、派生 URL 放在 Pipeline。
- Redis key 和 URL 模板优先放在 Item 类常量。
- 敏感连接信息使用环境变量管理。
scrapy-redis 把请求队列外置到 Redis,
而本项目的 Pipeline 把多个微博采集任务串成一条可断点续跑的分布式采集链路。